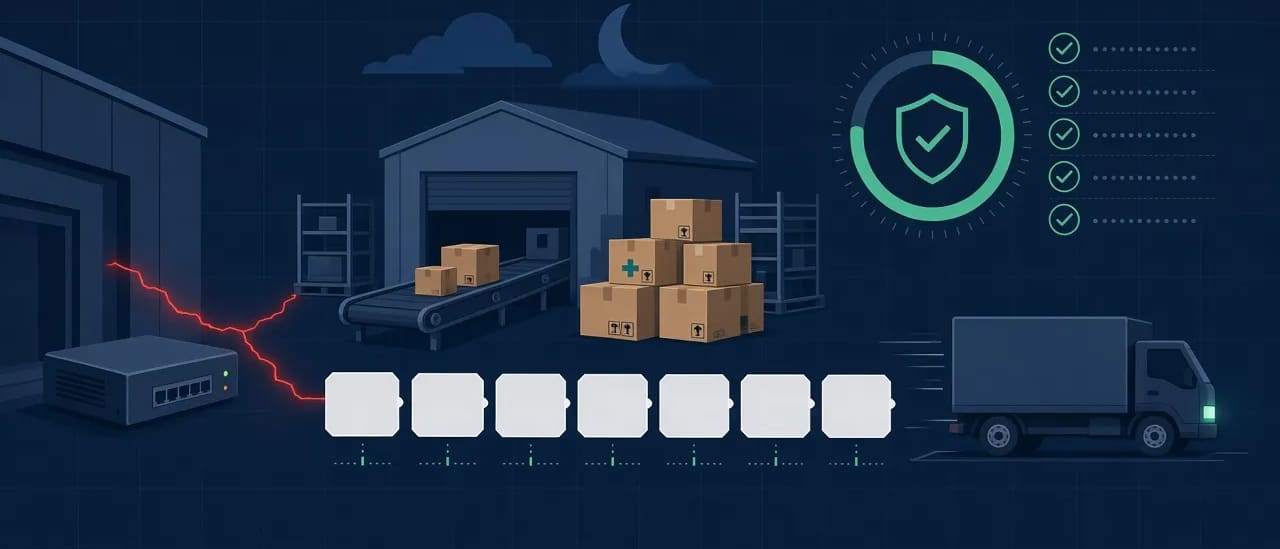
Banyak rencana pemulihan insiden berhenti di satu kalimat: "server sudah menyala lagi". Insiden siber Boston Scientific pada Agustus 2026 menunjukkan kenapa kalimat itu belum cukup. Tidak ada bukti data dienkripsi, tidak ada bukti data dicuri, tetapi kemampuan perusahaan memproduksi, memproses, dan mengirim pesanan terganggu secara global selama sekitar dua pekan.
Boston Scientific adalah produsen alat kesehatan seperti perangkat jantung implan. Perusahaan ini rutin menerbitkan pembaruan publik, laporan resmi ke regulator pasar modal Amerika Serikat (SEC), dan ringkasan investigasi dari CrowdStrike. Artikel ini merangkum fakta dari dokumen primer tersebut, lalu menerjemahkannya ke langkah praktis untuk rumah sakit, distributor, produsen, dan operator logistik di Indonesia.
Pemulihan selesai ketika pesanan, pengiriman, dan layanan pasien kembali normal, bukan ketika server kembali menyala.
Apa yang terjadi
Menurut pembaruan Boston Scientific 26 Agustus 2026, perusahaan mengidentifikasi insiden keamanan siber pada 25 Agustus 2026 yang menyebabkan gangguan jaringan dan mengganggu operasional. Akses ke sejumlah sistem operasi dan aplikasi bisnis terdampak, termasuk kemampuan memproses dan mengirim pesanan pelanggan.
Laporan Form 8-K yang diserahkan ke SEC (tanggal laporan 7 September 2026) menyebut insiden itu sebagai "gangguan global" terhadap operasional, yang memengaruhi kemampuan perusahaan memproduksi serta memproses dan mengirim pesanan.
Ada satu hal yang patut dicatat. Selama gangguan, menurut pembaruan 3 September 2026, pelanggan tetap bisa mengirim pesanan secara elektronik lewat EDI (pertukaran data elektronik) dan aplikasi lokal. Pesanan itu dimasukkan ke antrean untuk dipenuhi kemudian. Jalur masuk pesanan tetap hidup, sementara jalur pemrosesan dan pengiriman berhenti.
Gangguan juga menyentuh layanan pasien. Pembaruan yang sama menyatakan tidak ada dampak yang diketahui pada fungsi perangkat jantung yang sudah terpasang. Namun, aktivasi pemantauan jarak jauh untuk implan baru tidak bisa dilakukan, sehingga data dari perangkat baru belum terkirim ke sistem pemantauan sampai aktivasi pulih.
Kronologi singkat
| Tanggal (2026) |
Peristiwa menurut sumber primer |
| 25 Agustus |
Insiden teridentifikasi; jaringan terganggu, pemrosesan dan pengiriman pesanan terdampak |
| 3 September |
Pengiriman mulai dipulihkan untuk sebagian besar produk di pusat distribusi utama, seiring kapabilitas divalidasi |
| 7 September |
Form 8-K: pusat distribusi utama memproses pesanan pada atau di atas level normal; fasilitas sterilisasi beroperasi; produksi berjalan lagi di sebagian besar fasilitas |
| 9 September |
Produksi, pemenuhan pesanan, dan pengiriman dinyatakan pulih penuh; aktivasi pemantauan jarak jauh pulih |
| 22 September |
Ringkasan investigasi CrowdStrike dipublikasikan |
Pintu masuknya: perangkat jaringan yang menghadap internet
Ringkasan investigasi CrowdStrike menyebut investigasi berlangsung 25 Agustus sampai 18 September 2026. Pelaku masuk lewat perangkat manajemen jaringan yang menghadap ke luar (external-facing), lalu aksesnya terbatas pada sebagian lingkungan on-premises.
CrowdStrike tidak menemukan bukti enkripsi data, tidak menemukan aktivitas pelaku di Microsoft 365 dan email, dan tidak menemukan bukti data diakses, disiapkan, atau dikeluarkan dari sistem yang diperiksa, termasuk data pelanggan dan pasien. Sistem produksi, pemeliharaan alat kesehatan, SCADA, pengembangan perangkat lunak, serta sistem keuangan seperti Salesforce dan SAP juga tidak menunjukkan bukti akses.
Langkah penahanan yang dicatat cukup sederhana: perangkat pintu masuk diputus dan dipensiunkan, alamat IP dan domain pelaku diblokir di firewall, kata sandi diganti, dan lingkungan terdampak diperkuat. Pemantauan keamanan juga diperluas.
Pelajaran yang relevan untuk siapa pun
1. Tanpa enkripsi pun, operasi bisa berhenti. Banyak organisasi menilai risiko siber dari kemungkinan ransomware atau kebocoran data. Kasus ini menunjukkan gangguan jaringan pada sistem on-premises cukup untuk menghentikan proses inti. Dampaknya nyata: Form 8-K menyatakan insiden kemungkinan berdampak material pada hasil kuartal III dan tahun penuh 2026, dan perusahaan kemungkinan tidak memenuhi panduan pertumbuhan penjualan yang diberikan sebelumnya.
2. Perangkat di tepi jaringan adalah aset kritis. VPN, firewall, dan antarmuka manajemen jaringan sering dipasang sekali lalu jarang disentuh. Padahal di sinilah pintu masuk kasus ini.
3. Pemulihan bertahap dengan validasi. Pembaruan 3 September menyebut pengiriman dibuka kembali "seiring kapabilitas divalidasi". Urutan ini lebih aman daripada menyalakan semuanya sekaligus.
4. Pulih teknis tidak sama dengan pulih bisnis. Setelah pengiriman pulih penuh pada 9 September, perusahaan masih menyebut sebagian pelanggan bisa mengalami keterlambatan sementara karena antrean pesanan, dan aplikasi bisnis tertentu masih dipulihkan satu per satu.
5. Bukti menentukan seberapa cepat Anda bisa menenangkan mitra. Pernyataan bahwa SCADA, email, dan sistem keuangan tidak tersentuh hanya bisa dibuat karena ada jejak (log) yang bisa diperiksa. Tanpa log, jawaban jujurnya adalah "tidak tahu".
Apa artinya bagi organisasi di Indonesia
Rumah sakit dengan SIMRS on-premises, PBF dan distributor dengan gudang serta ERP sendiri, pabrik, dan operator logistik punya pola yang mirip: banyak proses inti masih berjalan di ruang server sendiri, dengan VPN atau firewall sebagai gerbang dari luar. Berikut lima langkah yang bisa dimulai bulan ini.
- Inventaris perangkat tepi. Daftar semua VPN, firewall, router, dan antarmuka manajemen yang bisa dijangkau dari internet, lengkap dengan versi firmware, pemilik, dan status dukungan vendor. Tutup antarmuka manajemen dari internet dan wajibkan MFA.
- Tentukan mode darurat per proses. Untuk setiap proses inti (pendaftaran pasien, penerimaan pesanan, pengeluaran barang), putuskan apa yang tetap berjalan saat sistem utama mati: antrean elektronik, formulir kertas, atau prosedur manual, lalu siapa yang memasukkan ulang datanya.
- Ukur pemulihan dengan angka bisnis. Selain "sistem menyala", ukur jumlah pesanan yang diproses per hari, umur antrean tertua, dan selisih antara pesanan masuk dan barang terkirim.
- Pastikan log cukup untuk menjawab "apa yang tidak tersentuh". Simpan log perangkat tepi, autentikasi, dan aplikasi inti di tempat terpisah dengan masa simpan yang jelas.
- Siapkan komunikasi ke mitra. Halaman pembaruan, FAQ, dan daftar kontak pelanggan serta pemasok penting. Boston Scientific memperbarui halamannya berkali-kali; pelanggan yang menunggu tahu apa yang bisa dan tidak bisa dilakukan.
Jika organisasi Anda termasuk penyelenggara layanan publik, artikel kami tentang pembentukan CSIRT dan peringatan BSSN relevan sebagai langkah berikutnya. Untuk sisi ketahanan infrastruktur, lihat juga pelajaran redundansi dari insiden Google Cloud.
Di mana MarkasDev bisa membantu
Langkah 1 dan 2 cocok dikerjakan sebagai Diagnose: pemetaan perangkat tepi, ketergantungan proses, dan mode darurat dengan temuan tertulis. Menjalankan pemantauan, patch perangkat, dan uji pemulihan secara rutin adalah inti Operate, dengan SLA dan laporan berkala.
Batasan
Artikel ini hanya bersandar pada dokumen yang diterbitkan Boston Scientific, laporan SEC-nya, dan ringkasan CrowdStrike. Kami tidak menebak identitas pelaku, jenis kerentanan perangkat, atau besaran kerugian finansial, karena sumber primer tidak menyebutkannya.
Mulai dari satu pertanyaan
Jika gerbang VPN Anda harus dimatikan malam ini, proses apa yang berhenti besok pagi, dan bagaimana pesanan atau pasien tetap dilayani? Ajukan Diagnose lewat halaman kontak, dan kami bantu memetakannya sebelum insiden yang memaksa.
Sumber
- Boston Scientific, Archived update on cybersecurity incident (26 Agustus 2026): https://news.bostonscientific.com/8-26-26-cyber-update-archive
- Boston Scientific, Archived update on cybersecurity incident (3 September 2026): https://news.bostonscientific.com/9-3-26-cyber-update-archive
- Boston Scientific, Form 8-K Item 1.05 (tanggal laporan 7 September 2026): https://www.sec.gov/Archives/edgar/data/885725/000088572526000059/bsx-20260907.htm
- Boston Scientific, Archived update on cybersecurity incident (9 September 2026): https://news.bostonscientific.com/9-09-26-cyber-update-archive
- Boston Scientific, Update on the August 25 cybersecurity incident (22 September 2026): https://news.bostonscientific.com/update-on-recent-cybersecurity-incident
- CrowdStrike Services, Investigation Summary untuk Boston Scientific (22 September 2026): https://filecache.mediaroom.com/mr5mr_bostonscientific/208705/download/Crowdstrike%20Investigation%20Summary%20%289.22.2026%29.pdf