Redundansi sering dijual sebagai asuransi: punya dua jalur, dua router, dua zona, maka satu kegagalan tidak akan terasa. Insiden Google Cloud pada 1 September 2026 menunjukkan celah yang jarang dibahas di rapat anggaran. Redundansi hanya bekerja bila prosedur yang menyentuhnya tidak bisa mencabut semuanya sekaligus.
Google menerbitkan laporan insiden lengkap pada 10 September 2026 dan tambahan pada 29 September 2026. Isinya jujur dan bisa dipelajari oleh siapa pun yang mengelola sistem kritis, baik di cloud, kolokasi, maupun ruang server sendiri. Artikel ini merangkum fakta dari laporan primer tersebut, lalu menerjemahkannya ke langkah untuk organisasi di Indonesia.
Redundansi yang bisa dicabut oleh satu instruksi kerja bukan redundansi. Ia hanya terlihat redundan di diagram.
Apa yang terjadi
Menurut halaman Google Cloud Service Health, pada Selasa 1 September 2026 sebagian pelanggan di wilayah us-central1 mengalami degradasi layanan jaringan dan isolasi instans selama 4 jam 11 menit, dari pukul 07.41 sampai 11.52 waktu Pasifik (sekitar pukul 21.41 WIB sampai 01.52 WIB keesokan harinya).
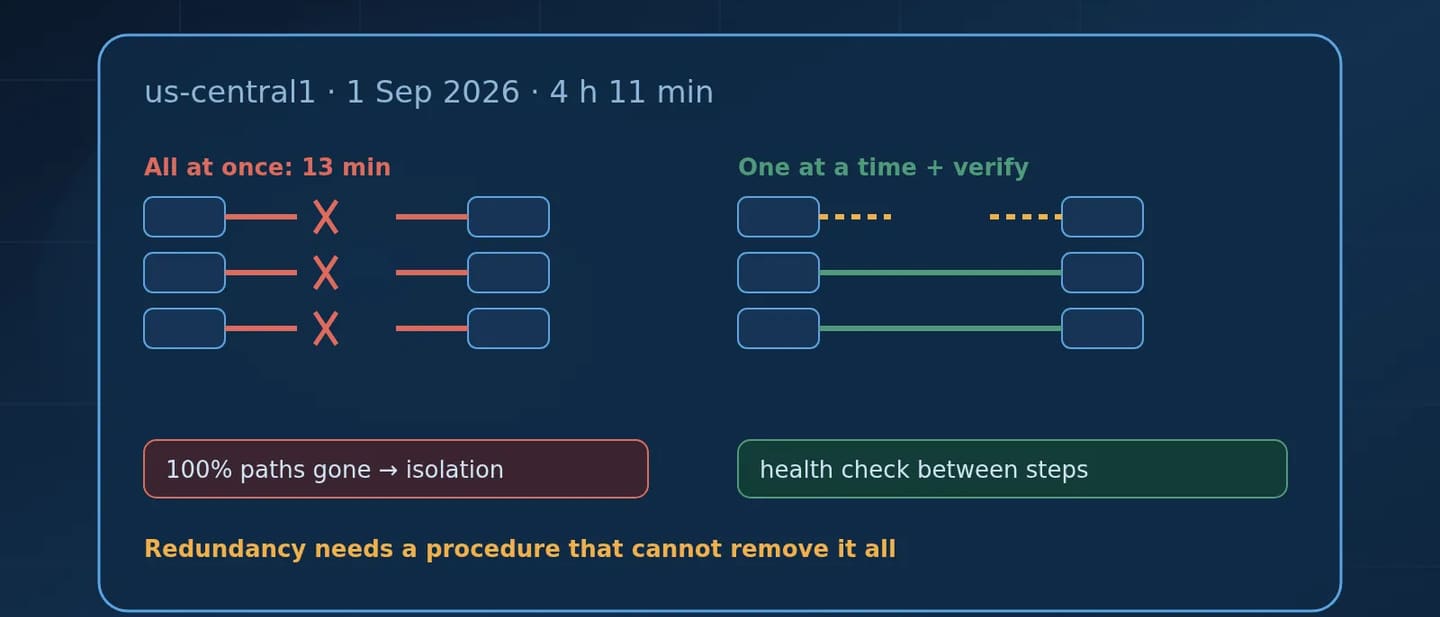
Pemicunya adalah pencabutan kabel serat optik secara tidak sengaja saat pemeliharaan perangkat keras rutin. Seorang teknisi melakukan peningkatan kapasitas pada router pusat data. Jaringan itu dirancang dengan router redundan di ruang pusat data yang terpisah dalam satu gedung, sehingga kegagalan satu router tidak mengganggu layanan. Pemeliharaan semestinya dilakukan satu router per kali selama beberapa hari, dengan pengalihan lalu lintas dan verifikasi di tiap langkah.
Yang terjadi sebaliknya. Menurut Google, kesalahan prosedur pada proses peningkatan yang dikoordinasikan secara manual menyebabkan seluruh daftar penggantian transceiver untuk semua router diberikan kepada teknisi tanpa instruksi urutan satu router per kali. Alur kerja itu juga tidak memuat langkah verifikasi manusia dan perangkat lunak untuk mendeteksi gangguan tak disengaja. Hasilnya, seluruh jalur serat pada perangkat terdampak dicabut berurutan dalam 13 menit. Peringatan tidak sempat sampai ke teknisi, dan prosedur tetap untuk berhenti bila masih terdeteksi cahaya pada kabel setelah dicabut tidak dijalankan.
Dampaknya: laju penurunan aliran lalu lintas mencapai 100 persen pada puncaknya, mesin virtual tidak terjangkau, dan banyak produk terdampak, dari Compute Engine, Cloud SQL, hingga GKE.
Tambahan 29 September: dampak merambat
Pada tambahan laporan 29 September 2026, Google menjelaskan bahwa produk regional yang bergantung pada pusat data terdampak juga ikut terganggu, termasuk beberapa jenis load balancer dan koneksi hibrida. Ada juga efek susulan di Cloud Run dan App Engine: setelah klaster pulih, lonjakan inisialisasi instans serentak (thundering herd) membebani lapisan penyimpanan berkas dan memperpanjang gejala sampai kapasitas darurat disiapkan. Dalam insiden ini, pemulihan memunculkan masalah baru; ia perlu direncanakan sama seriusnya dengan pencegahan.
Siapa yang selamat
Google menyatakan bahwa penerapan multi-zona yang benar, yaitu menyebar di zona lain dalam wilayah yang sama, umumnya dapat menghindari kegagalan perangkat keras ini dan tetap melayani lalu lintas. Pelanggan dengan sumber daya di klaster terdampak kehilangan konektivitas sepenuhnya. Pesannya praktis: desain Anda yang menentukan, bukan nama penyedianya.
Perbaikan yang diumumkan Google adalah daftar periksa
Google menyebut empat langkah pencegahan:
- Pelatihan ulang tentang teknik pemeliharaan aman, termasuk kewajiban memverifikasi apakah ada cahaya pada setiap serat yang dicabut.
- Menyelesaikan migrasi alur peningkatan jaringan ke sistem orkestrasi yang berurutan otomatis. Alur regional umum selesai pada 2025, alur zonal masih berjalan.
- Peringatan penghentian kerja untuk tindakan yang memutus serat aktif secara tidak sengaja.
- Sistem otomatis yang memindahkan lalu lintas regional dari zona bermasalah, sehingga waktu pengalihan turun dari sekitar 19 menit menjadi sekitar 5 menit.
Menurut kami, ini bukan khas Google. Pola yang sama berlaku untuk pembaruan database, perubahan firewall massal, atau patch server yang dijalankan ke seluruh armada sekaligus.
Apa artinya bagi organisasi di Indonesia
Bagian ini adalah penafsiran kami atas laporan Google.
Rumah sakit, bank daerah, dan perusahaan logistik yang menaruh sistem inti di satu zona atau satu ruang server perlu memeriksa satu hal sebelum yang lain: kalau semua jalur ke zona itu hilang bersamaan, apa yang terjadi pada layanan Anda? Jika jawabannya "kami belum pernah menguji", itu temuan.
Pemda dan BUMD yang bergantung pada penyedia kolokasi atau layanan terkelola sebaiknya meminta penyedia menjelaskan cara mereka mengurutkan pekerjaan pemeliharaan, termasuk verifikasi di antara langkah dan batas dampak untuk perubahan massal. Pertanyaan ini wajar masuk ke SLA dan jadwal pemeliharaan.
Tim internal perlu menerapkan hal yang sama pada perubahan mereka sendiri. Patch yang dijalankan serentak ke semua server, atau skrip yang menerapkan konfigurasi ke seluruh node, mengubah cadangan menjadi satu unit yang senasib.
Satu catatan jujur: kegagalan multi-zona tidak menolong bila aplikasi Anda sendiri hanya berjalan di satu zona. Laporan Google menunjukkan bahwa yang tertolong adalah penerapan yang memang sudah menyebar.
Pelajaran yang sama di lapisan AI
Pada 3 September 2026, menurut catatan riset Cloud Security Alliance, tiga layanan AI percakapan terkemuka mengalami gangguan yang saling tumpang tindih dalam jendela tiga jam yang sama. Masing-masing penyedia menyebut penyebab berbeda atau belum menjelaskannya, dan catatan itu menyatakan tidak ada penyebab bersama yang terkonfirmasi. Catatan itu juga menyebut dirinya dibuat dengan bantuan AI dan belum melalui proses tinjauan resmi CSA, jadi kami memakainya hanya untuk gambaran umum.
Rekomendasinya mirip dengan pelajaran di atas: inventarisasi proses yang bergantung pada penyedia AI (termasuk AI yang tertanam di perangkat lunak pihak ketiga), pantau titik akhir AI yang Anda pakai secara mandiri, dan siapkan jalur cadangan yang benar-benar diuji, bukan sekadar pengalih yang tidak punya tujuan.
Lima langkah minggu ini
- Petakan titik tunggal. Untuk tiap layanan kritis: satu zona, satu penyedia, satu orang, atau satu skrip yang bisa memengaruhi semua instansnya?
- Urutkan perubahan massal. Terapkan ke satu node atau satu zona dulu, periksa kesehatan, lalu lanjut. Tulis batas jumlah per langkah.
- Tambahkan pemeriksaan di antara langkah. Syarat lulus yang jelas dan wewenang menghentikan pekerjaan bagi siapa pun yang menemukan anomali.
- Uji pengalihan sungguhan minimal setahun sekali, termasuk pemulihan bertahap agar tidak memicu lonjakan serentak.
- Tulis dependensi eksternal termasuk layanan AI yang dipakai, dengan kontak insiden dan rencana cadangannya.
Langkah 1 dan 4 adalah pekerjaan Diagnose yang menghasilkan temuan tertulis. Menjaga disiplin perubahan dan pemantauan setelah itu adalah inti Operate. Bila Anda perlu menata server dan lingkungan aplikasi dengan patch terjadwal dan cadangan terverifikasi, lihat layanan server dan lingkungan.
Batasan
Kami hanya merujuk pada halaman status Google Cloud sebagai sumber primer insiden, dan pada catatan CSA untuk peristiwa AI. Kami tidak menilai desain arsitektur pelanggan tertentu, tidak menghitung kerugian finansial, dan tidak mengklaim bahwa penyedia lain bebas dari risiko serupa.
Mulai dari satu pertanyaan
Jika seluruh jalur ke satu zona hilang malam ini, layanan apa yang berhenti, dan siapa yang tahu langkah pertamanya? Kami bisa membantu memetakannya sebelum anggaran besar terkunci. Ajukan Diagnose lewat halaman kontak.
Sumber
- Google Cloud Service Health — Incident J5ia5t9p3g9Q5Wi7r8Ev (laporan 10 September dan tambahan 29 September 2026): https://status.cloud.google.com/incidents/J5ia5t9p3g9Q5Wi7r8Ev
- Cloud Security Alliance — The Triple AI Outage: A Wake-Up Call for AI Continuity (19 September 2026): https://labs.cloudsecurityalliance.org/wp-content/uploads/2026/09/CSA_research_note_triple_ai_outage_concentration_risk_20260919-csa-styled.pdf