Rabu dini hari, 7 Oktober 2026, sekitar pukul 03.40 waktu Jepang, mesin virtual di empat zona IDCF Cloud wilayah Jepang Timur 1 berhenti dan tidak bisa dinyalakan lagi. IDC Frontier, anak usaha SoftBank yang menyewakan server virtual, storage, dan jaringan, mengonfirmasi penyebabnya serangan ransomware. Ada 495 organisasi pelanggan yang terdampak.
Kalimat paling penting justru muncul di laporan ketiga perusahaan itu, sehari kemudian. Data pelanggan di zona yang terkena diperkirakan sulit diambil atau dipulihkan, dan menurut IDC Frontier, pemulihan saat itu hanya mungkin dari cadangan yang disimpan pelanggan sendiri.
Bagi banyak bisnis, kalimat itu membalik asumsi lama: "datanya kan sudah di cloud, berarti aman."
Apa yang terjadi, dan apa yang belum pasti
Setelah serangan terdeteksi, IDC Frontier memutus jaringan wilayah tersebut dan menghentikan konsol manajemen pelanggan, termasuk di wilayah lain yang tidak terkena, sambil memeriksa keamanannya. Selama konsol mati, menyalakan atau mematikan server pelanggan dilakukan oleh IDC Frontier atas permintaan.
Tangkapan layar yang beredar dari konsol pelanggan memuat klaim pelaku: masuk dalam tujuh menit, menjangkau 239 hypervisor, mengenkripsi 225 basis data sebesar 3,6 petabyte, mengunci lebih dari 16.000 disk mesin virtual, dan menghapus 554.153 snapshot. Ini klaim pelaku yang belum diverifikasi, tetapi cukup menggambarkan satu hal: snapshot yang tinggal di platform yang sama ikut berada dalam jangkauan penyerang.
Pada 14 Oktober, laporan kelima IDC Frontier menyatakan tidak ditemukan jejak data di dalam mesin virtual dibawa keluar. Bersama perusahaan keamanan eksternal, IDC Frontier juga memastikan cadangan milik 194 pelanggan yang memakai fitur snapshot bisa diambil, dengan kelayakan pemulihannya dibahas satu per satu. Laporan itu tidak menyinggung pelanggan yang tidak memakai snapshot. Di portal pelanggan, data pendaftaran 48 perusahaan ternyata sempat diakses tanpa izin. Pada 18 Oktober, layanan backup dibuka lagi untuk zona yang tidak terdampak, sehingga data bisa dipulihkan ke cloud lain atau ke server sendiri. Fitur snapshot masih dihentikan.
Dampaknya langsung terasa di operasi. Nissui Logistics, yang mempercayakan operasional sistemnya ke IDC Frontier, berhenti menerima dan mengirim barang di semua gudangnya. Operasi sebagian kembali pada 9 Oktober, dan sistem baru di server lain ditargetkan normal pada pekan 19 Oktober. ITmedia merangkum pengumuman lebih dari selusin perusahaan terdampak per 19 Oktober, dan polanya jelas.
- Cadangan sendiri, di tempat lain. Six Apart memakai cadangan 7 Oktober pukul 01.00 dan memindahkan 31 servernya ke Sakura Cloud sebelum pukul 21.00 keesokan harinya. CareNet menilai pemulihan di IDCF tidak bisa diandalkan, lalu membangun ulang layanannya di penyedia lain dari cadangan terakhir sebelum serangan. Situsnya kembali pada 11 Oktober, empat hari setelah insiden.
- Umur cadangan menentukan data yang kembali. Layanan sinkronisasi stok marketplace "Rakuraku Zaiko" milik Greenwich pulih pada 9 Oktober, tetapi dari cadangan 30 Agustus. Pesanan selama gangguan tidak ikut masuk, dan toko pengguna diminta memperbarui jumlah stok sebelum sinkronisasi dinyalakan lagi.
- Fungsi inti dipisah dari fungsi pendukung. Mouse Computer tidak menyimpan data pesanan dan pembayaran di platform itu, sehingga toko online-nya tetap buka meski newsletter berhenti. Platform e-commerce FutureShop hanya menaruh server pengirim email di IDCF, dan datanya terenkripsi serta otomatis terhapus 14 hari setelah dikirim. Pengiriman email dialihkan ke data center lain pada 9 Oktober.
- Ketergantungan tidak langsung. JR East, Takashimaya, dan View Card tidak berlangganan IDCF sendiri, tetapi vendor pengiriman email mereka berjalan di sana. Di toko online JR Central, email autentikasi yang tidak terkirim berarti pelanggan tidak bisa login dan membeli.
Ini bukan kasus langka. ITmedia mengutip survei ITR Maret 2025: 47% perusahaan yang terkena ransomware mendapati data cadangannya ikut terenkripsi.
Apa artinya bagi bisnis di Indonesia
Banyak bisnis di Indonesia, dari toko online, distributor, dan klinik swasta sampai perusahaan logistik, menyewa VPS atau cloud lokal dan memakai banyak SaaS: email blast, WhatsApp blast, sinkronisasi stok marketplace, POS, akuntansi. Itu pilihan yang masuk akal. Masalahnya muncul ketika tidak ada yang tahu persis di mana data itu berada dan bagaimana mengembalikannya jika penyedianya lumpuh.
Tujuh langkah yang bisa dimulai minggu ini:
- Petakan ketergantungan sampai lapis kedua. Untuk setiap sistem dan vendor SaaS, tanyakan: berjalan di cloud siapa, di wilayah mana, dan apa yang berhenti di bisnis Anda jika layanan itu mati tiga hari. Insiden ini menunjukkan vendor email Anda bisa menjadi titik lumpuh login dan transaksi.
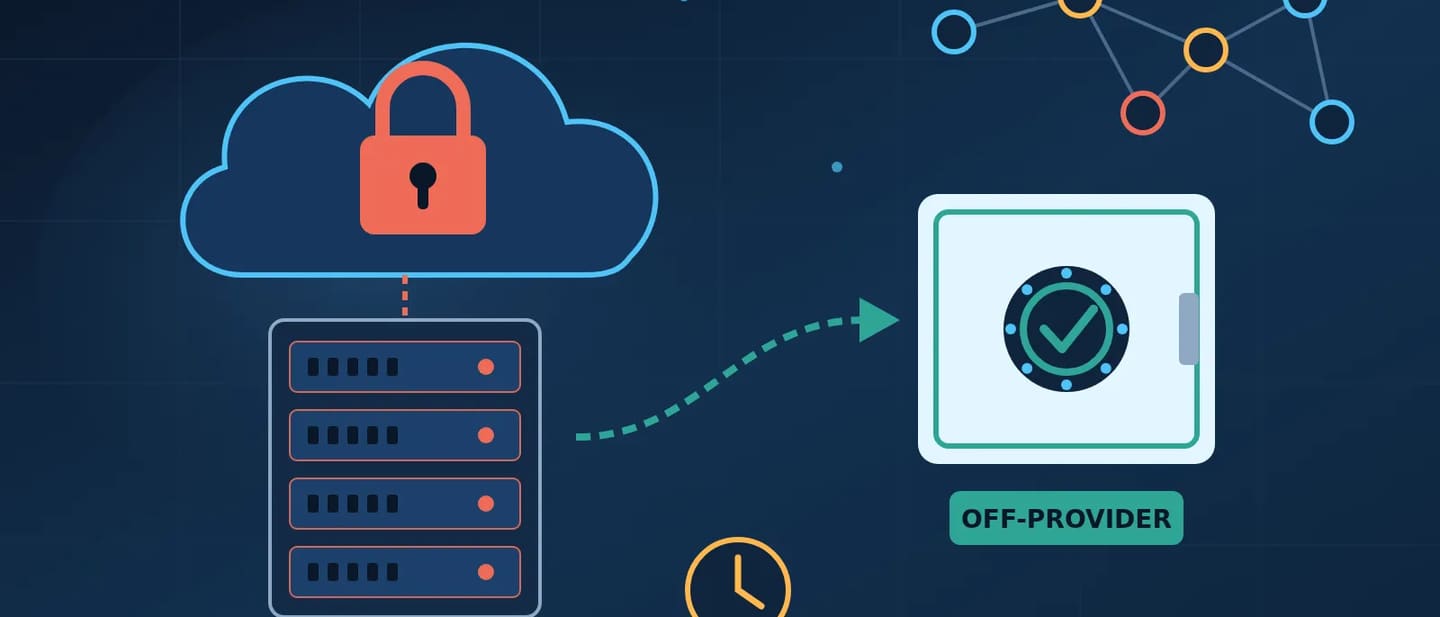
- Simpan minimal satu cadangan di luar penyedia dan akun yang sama. Snapshot di platform yang sama berguna untuk salah konfigurasi, bukan untuk serangan yang menguasai platform. Gunakan akun, kredensial, dan sebaiknya penyedia yang berbeda, plus salinan yang tidak bisa diubah atau dihapus selama periode tertentu.
- Tetapkan RPO dan RTO per sistem, lalu cocokkan dengan kenyataan. Berapa jam data boleh hilang, dan berapa lama layanan boleh mati? Kasus Greenwich menunjukkan jadwal cadangan yang longgar langsung berubah menjadi pesanan hilang dan stok yang harus dihitung ulang.
- Latih pemulihan ke lingkungan lain, bukan hanya restore file. Six Apart bisa pindah dalam waktu kurang dari dua hari karena cadangan dan tempat tujuannya tersedia. Uji juga DNS, rahasia aplikasi, sertifikat, dan dokumentasi langkahnya, setidaknya untuk sistem paling kritis.
- Pisahkan fungsi inti dari fungsi pendukung. Data pesanan, pembayaran, dan stok sebaiknya tidak ikut tumbang karena sistem pemasaran tumbang. Ini sejalan dengan pelajaran redundansi yang tidak boleh dicabut sekaligus.
- Titipkan data seperlunya ke vendor. Batasi kolom data dan masa simpannya, seperti penghapusan otomatis 14 hari di FutureShop. Semakin sedikit data di vendor, semakin kecil dampaknya saat vendor itu diserang.
- Tulis jalan keluar di kontrak dan siapkan komunikasi. Pastikan hak ekspor data dalam format terbuka, kewajiban pemberitahuan insiden, dan keterbukaan soal subkontraktor hosting. Soal format, lihat rencana keluar dengan format data terbuka. Siapkan juga template pemberitahuan pelanggan, karena JR Central memperingatkan potensi email, SMS, dan telepon palsu yang menumpang insiden ini.
Server yang menyala lagi belum tentu berarti bisnis sudah pulih, seperti kami bahas dalam pelajaran insiden Boston Scientific. Ukuran yang benar adalah pesanan kembali masuk, stok kembali akurat, dan pelanggan kembali bisa login.
Peran MarkasDev
MarkasDev bekerja sebagai Technology Partner untuk keandalan operasional, dalam tiga fase:
- Diagnose: memetakan sistem, vendor, dan lokasi hosting sampai lapis kedua, menilai cadangan yang ada terhadap RPO dan RTO yang dibutuhkan bisnis, lalu menyusun prioritas perbaikan.
- Deliver: membangun cadangan di luar penyedia utama, memisahkan fungsi inti dari fungsi pendukung, dan menyiapkan lingkungan pemulihan yang teruji, dengan milestone dan kriteria penerimaan tertulis.
- Operate: retainer dengan SLA dan monitoring untuk menjalankan latihan pemulihan rutin dan memastikan cadangan benar-benar bisa dipakai. Bedanya dengan sekadar memperbaiki saat rusak kami jelaskan di Maintenance vs Operate.
Jika Anda belum yakin cadangan Anda akan selamat bila penyedia cloud ikut terkunci, jadwalkan sesi Diagnose untuk memeriksa peta ketergantungan dan rencana pemulihannya.
Sumber
- IDC Frontier, laporan ke-3 insiden IDCF Cloud (8 Oktober 2026): https://www.idcf.jp/news/topics/20261008001
- IDC Frontier, laporan ke-6, pembukaan kembali layanan backup (18 Oktober 2026): https://www.idcf.jp/news/topics/20261018001
- ITmedia Enterprise, rangkuman dampak dan pemulihan perusahaan pengguna IDCF Cloud (20 Oktober 2026): https://www.itmedia.co.jp/enterprise/articles/2610/16/news098.html
- ASCII.jp English Edition, "IDC Frontier: Backup Data Now Retrievable for 194 Customers" (15 Oktober 2026): https://ascii.jp/en/elem/000/004/442/4442704/
- BleepingComputer, "Ransomware attack disrupts Japan's IDCF Cloud" (8 Oktober 2026): https://www.bleepingcomputer.com/news/security/ransomware-attack-disrupts-japans-idcf-cloud-used-by-govt-clients/
- Cybernews, "Cyberattack on Japanese cloud firm hits railways, police and food suppliers" (9 Oktober 2026, diperbarui 12 Oktober): https://cybernews.com/security/japanese-cloud-cyberattack-railways-police-495-organizations-idcf/